DORA-metrics lezen als AI de helft van je commits schrijft
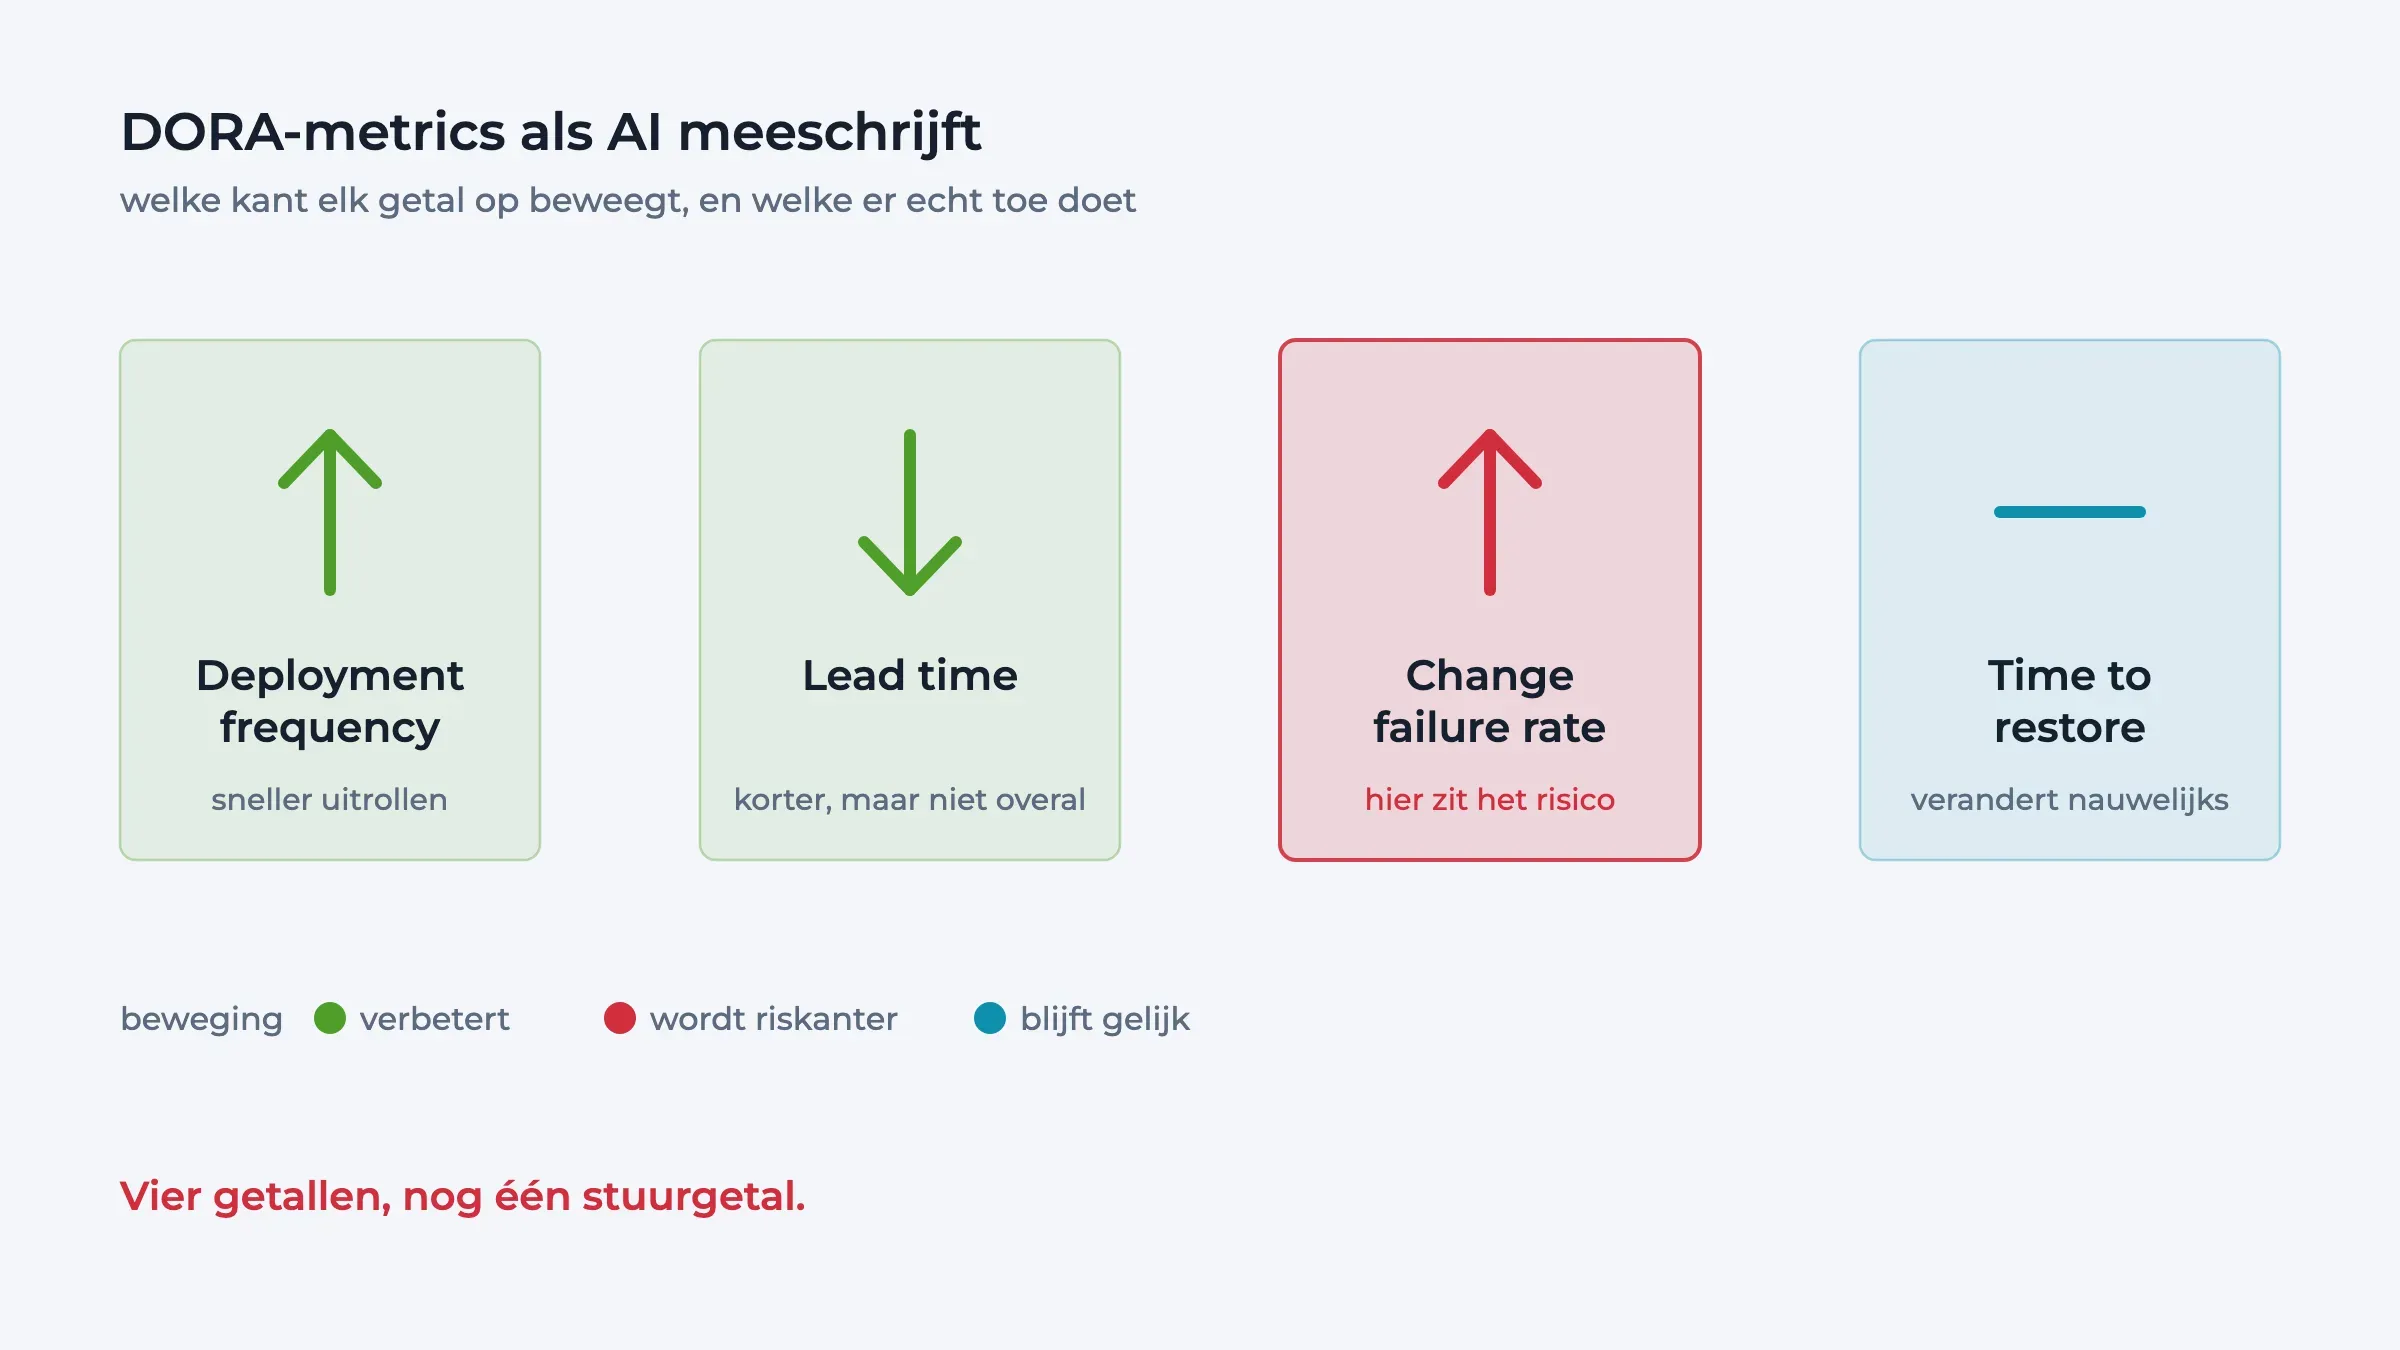
Je DORA-dashboard toont nog steeds dezelfde vier getallen. Alleen betekenen ze niet meer hetzelfde.
Zodra een flink deel van je code niet meer met de hand geschreven wordt, verschuift wat elk van die metrics je vertelt. Sommige gaan omhoog zonder dat er iets verbeterd is. Eén wordt plotseling veel belangrijker dan de rest. En de naïeve lezing (“onze deployment frequency stijgt, dus het gaat goed”) wijst precies de verkeerde kant op.
Waar DORA voor gemaakt is
De vier DORA-metrics meten je software delivery, niet je productiviteit. Dat onderscheid is altijd al belangrijk geweest, maar met AI in de mix wordt het bepalend. DORA zelf omschrijft de vier zo:
- Deployment frequency: hoe vaak je naar productie brengt.
- Lead time for changes: hoe lang het duurt van commit tot productie.
- Change failure rate: welk deel van je wijzigingen problemen veroorzaakt.
- Time to restore: hoe snel je herstelt als het misgaat.
Geen van deze vier meet hoeveel code je schrijft. Dat was ooit een detail. Nu is het de kern: code schrijven is niet langer je bottleneck, dus een metric die code-volume negeert is precies wat je nodig hebt.
De snelheidskant beweegt, en zegt het minst
Deployment frequency beweegt het snelst als je AI-tooling invoert, en misleidt het makkelijkst. Meer wijzigingen komen sneller klaar, dus er gaan meer wijzigingen naar productie. Je grafiek gaat omhoog. Iemand zet hem in een presentatie. Maar deployment frequency meet beweging, geen vooruitgang. Als de extra deploys bestaan uit wijzigingen die niemand gevraagd heeft, of uit correcties op wijzigingen van vorige week, dan is je grafiek een teller van activiteit. Kijk er dus nooit naar zonder de change failure rate ernaast te leggen. Stijgen ze samen, dan is er geen winst, alleen meer verkeer.
Lead time for changes is een optelsom: nadenken, schrijven, reviewen, testen, wachten op goedkeuring, uitrollen. AI verkort betrouwbaar precies één van die stappen. De rest blijft staan waar hij stond. Dat betekent dat je totale lead time veel minder daalt dan je verwacht, en dat de verhouding binnen die optelsom scheeftrekt. Waar schrijven vroeger misschien een derde van de doorlooptijd was, is het nu een fractie, en is wachten op een reviewer of op een pipeline verhoudingsgewijs veel dominanter geworden. Dat is juist de meest bruikbare informatie die je uit deze metric kunt halen. Splits je lead time op in fases zodra je AI serieus inzet. Zonder die opsplitsing zie je één getal dat licht verbetert; mét die opsplitsing zie je precies waar je volgende uur winst ligt.
De stabiliteitskant: vertrouwen wordt het schaarse goed
Als code goedkoop wordt om te maken, wordt het duur om te vertrouwen. Dat maakt de change failure rate de metric waar je het scherpst op moet letten. Niet omdat AI-code per se slechter is (dat argument is grotendeels achterhaald), maar omdat er méér van komt, sneller, en met minder mensen die elke regel echt gelezen hebben. Twee dingen om in de gaten te houden. Ten eerste een stijging die samenvalt met je AI-invoering: dat is het signaal dat je snelheid je controlemechanismen voorbij is gelopen. Ten tweede, en subtieler, een change failure rate die gelijk blijft terwijl je deployment frequency verdubbelt. Dat betekent in absolute zin twee keer zoveel incidenten, en dat verhullen percentages.
Time to restore reageert van de vier het minst op AI-tooling, en juist daarom is hij zo informatief. Herstellen na een incident hangt af van je observability, je runbooks, je rollback-mechanismen en of de juiste persoon bereikbaar is. Een model dat sneller code schrijft, raakt daar niets van. Dus als je deployment frequency omhoog gaat, je lead time daalt en je time to restore blijft precies waar hij was, dan heb je de risicokant van je systeem niet meegeschaald met de snelheidskant. Dat is een prima situatie om in te zitten zolang je het wéét, en een uitstekende manier om verrast te worden als je het niet meet.
Wat je erbij moet meten, en hoe je het inricht
DORA blijft belangrijk, maar het is niet meer voldoende. Drie aanvullingen die in een AI-zware workflow het meeste opleveren:
-
Review-latency. De tijd tussen “klaar voor review” en “gereviewd”. Dit is in de meeste teams inmiddels de grootste enkele post in je lead time, en hij wordt zelden apart bijgehouden.
-
Rework-ratio. Welk deel van je wijzigingen binnen bijvoorbeeld twee weken alweer aangeraakt wordt. Stijgt dit terwijl je sneller levert, dan produceer je herstelwerk in plaats van vooruitgang.
-
Aandeel AI-ondersteunde wijzigingen. Je hoeft niet elke regel te herleiden; zonder enige indicatie kun je geen enkele uitspraak doen over wat AI je gebracht heeft. Zelfs een grove markering op PR-niveau maakt het verschil tussen meten en gokken.
Begin met een nulmeting vóór je AI-tooling breed uitrolt. Zonder die basislijn kun je achteraf niets aantonen, en precies dát is waar de meeste discussies over AI-investeringen op stuklopen: iedereen heeft een mening, niemand heeft een grafiek van ervoor. Splits daarna je lead time op in fases, en zet review-latency en rework-ratio ernaast. Bekijk change failure rate altijd in absolute aantallen naast het percentage. Dit is precies het soort meting waar Agile Analytics, onze meetengine, voor gebouwd is: DORA en SPACE naast elkaar, met de fases uitgesplitst, zodat je ziet waar je doorlooptijd werkelijk heen gaat in plaats van één samengevat getal.
Meet het voordat je het viert
AI verandert je DORA-metrics niet. Het verandert wat ze betekenen: deployment frequency wordt gevoelig voor ruis, lead time verschuift van schrijven naar wachten, change failure rate wordt je belangrijkste signaal en time to restore verraadt of je risicobeheersing is meegegroeid.
Mijn voorspelling: de teams die over een jaar kunnen aantonen wat AI ze heeft opgeleverd, zijn niet de teams met de hoogste deployment frequency. Het zijn de teams die vóór de uitrol een nulmeting deden en hun lead time in fases knipten. De rest heeft een grafiek die omhoog loopt en een discussie die nergens heen gaat. Kies dus nu, voordat de tooling breed staat, in welke van die twee groepen je wilt zitten.

Blije Nerds zijn productieve Nerds
Implementeer supersnel DevOps en SRE met Agile Analytics. Vraag het onze Agile Nerds.
AI consultancy
AI inzetten waar het echt scheelt, met de verantwoordelijkheid bij mensen.
Lees ook:
Software ontwikkelen met behulp van AI en rekening houden met AVG, NIS2 en DORA compliance
Zodra je een coding agent aan je codebase hangt, raak je drie regimes tegelijk. Niet omdat AI apart gereguleerd is, maar...
In 1988 legde een student een tiende van het internet plat. Wat deden we daarna?
In november 1988 schreef een student aan Cornell een programmaatje dat moest tellen hoeveel computers er aan het interne...
OpenAI's AI-agents braken in bij een ander bedrijf. Waarom noemen we dat opeens een complot?
OpenAI's AI-agents braken deze zomer in bij Hugging Face, een ander AI-bedrijf. Volgens Dwarkesh Patel was het een AI-be...
Een AI-abonnement van 200 dollar levert 14.000 dollar aan rekenkracht op. Maar klopt die som?
Een ChatGPT Pro-abonnement van 200 dollar zou 14.000 dollar per maand aan rekenkracht opleveren. Zo gaat de screenshot r...
AI-gegenereerde infrastructuurcode reviewen: waar je écht naar moet kijken
Applicatiecode die fout is, gaat meestal stuk. Infrastructuurcode die fout is, werkt. En dat is precies het probleem. Ee...
Wat dertig minuten wachten per engineer per dag echt kost
Een half uur per dag, zo weinig lijkt het. Maar reken het door en het is €5.000 per engineer per jaar, of een half miljo...